
🔬 Los autores de un estudio publicado en Nature adaptaron modelos de lenguaje existentes para procesar texto como bytes. Su método, «byteification», usó menos del 1 % del presupuesto habitual de preentrenamiento y mejoró el manejo de caracteres. El resultado apunta a ventajas para tareas donde cada carácter importa, como el código.
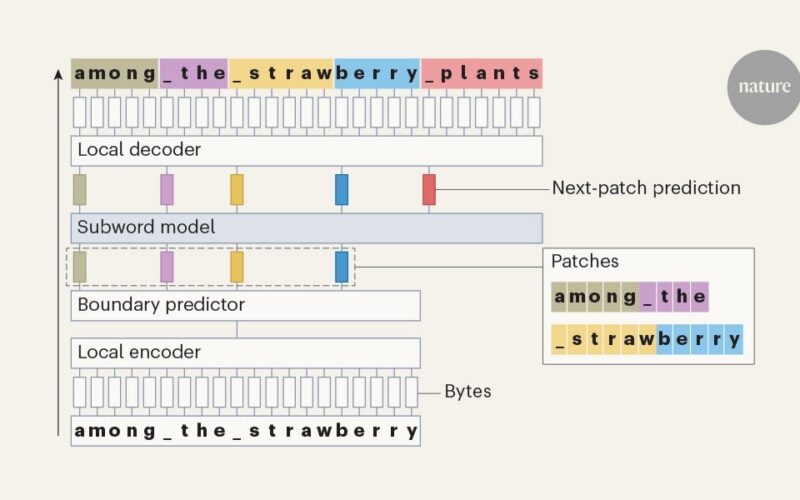
Los modelos habituales dividen el texto en palabras o fragmentos. Esa división puede ocultar detalles cruciales del código o las secuencias biológicas. El nuevo diseño recibe los bytes que codifican el texto, los agrupa en bloques y reutiliza el núcleo del modelo original. Después, vuelve al nivel de bytes para generar texto.
El equipo convirtió modelos de las familias OLMo, Qwen y Llama mediante dos etapas de entrenamiento. Primero, mantuvo fijo el núcleo y entrenó los componentes nuevos para imitar el modelo original. Después, entrenó todo el sistema para aprovechar los detalles del texto a escala de bytes. El proceso empleó 49 100 millones de tokens en total.
Los modelos adaptados superaron, en promedio, a los modelos anteriores basados en bytes de tamaño comparable. Bolmo 7B logró una ventaja de 16,5 puntos porcentuales frente a BLT 7B en tareas STEM. También superó al OLMo 3 original en tareas de caracteres. En las pruebas generales, los modelos convertidos se acercaron al rendimiento de sus modelos de origen.
✅ El método podría facilitar modelos que manejen mejor el código y las secuencias biológicas sin entrenarlos desde cero. La ventaja no fue uniforme: algunas pruebas de código empeoraron al evaluar una sola respuesta. Agrupar más bytes aceleró los modelos, pero redujo su rendimiento.