
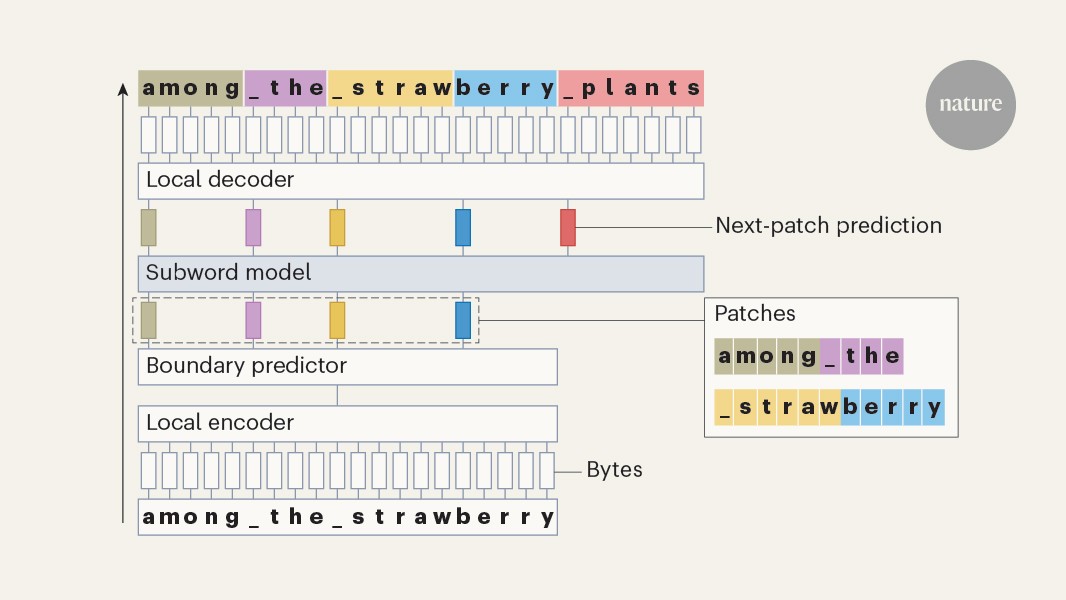
🔬 El equipo de Minixhofer presenta en Nature «byteification», una técnica que adapta modelos de lenguaje existentes para leer caracteres individuales. Sus resultados sugieren que pueden mantener un rendimiento competitivo y leer cada carácter. El enfoque aborda una dificultad concreta: muchos modelos fallan al contar las letras de una palabra.
La palabra inglesa «strawberry» contiene tres letras «r», pero muchos modelos responden que tiene dos. La mayoría procesa palabras mediante tokens: unidades que representan secuencias de letras. Esa forma de trabajar permite un buen rendimiento, pero impide acceder a cada carácter por separado.
«Byteification» adapta modelos basados en tokens para que operen con bytes. Los bytes son las secuencias binarias en las que están codificados los caracteres.
✅ El enfoque apunta a modelos capaces de examinar un texto letra por letra sin renunciar a un rendimiento competitivo. El texto no aporta cifras ni detalla las pruebas usadas para evaluar ese rendimiento.