
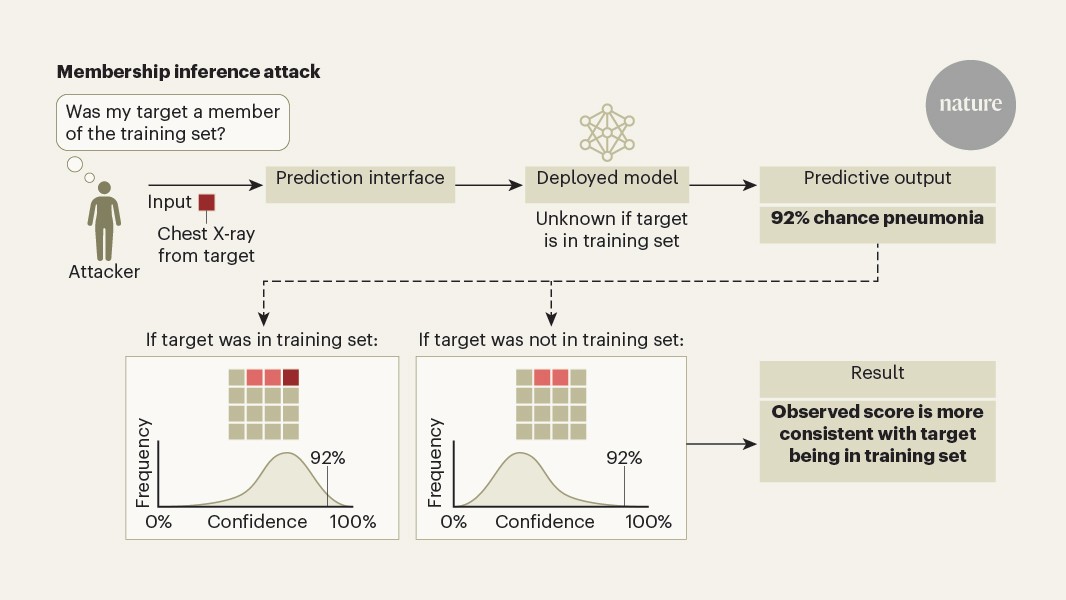
🔬 Un artículo de Nature explica que los ataques de privacidad contra modelos de inteligencia artificial médica pueden revelar si los datos de una persona sirvieron para entrenarlos. El trabajo de Knolle y colegas indica que ese riesgo no se reparte por igual: quienes se alejan de la mayoría son más vulnerables.
La adopción de herramientas de IA en medicina se ha apoyado en registros sensibles sin nombres u otros datos personales. A cambio, investigadores y desarrolladores aspiran a crear herramientas que adelanten diagnósticos y ayuden a encontrar tratamientos.
El supuesto central era que quien accediera a un modelo no podría deducir información sobre las personas cuyos registros participaron en el entrenamiento. Knolle y colegas muestran que, con modelos potentes de aprendizaje automático, ese supuesto suele fallar.
✅ El hallazgo sugiere que proteger la privacidad no consiste solo en eliminar identificadores de los registros. También exige atender a quién queda más expuesto cuando un modelo aprende de datos médicos. El texto no cuantifica aquí la frecuencia ni las condiciones de estos ataques, así que no permite estimar el riesgo para cada sistema.
⚕️ No es consejo médico.