
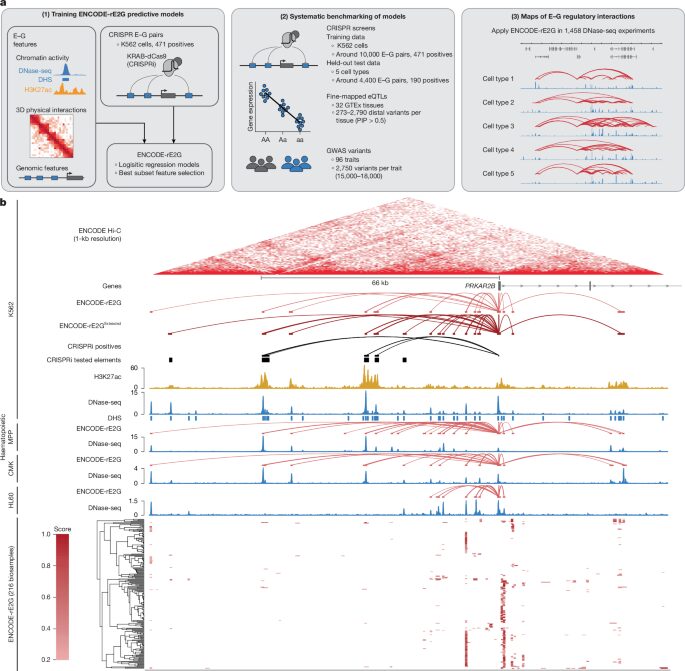
🔬 Un equipo vinculado al Consorcio ENCODE creó y evaluó un recurso con más de 92 millones de interacciones entre potenciadores (enhancers) y genes en el genoma humano. Integra modelos predictivos, estados de cromatina, contactos 3D y perturbaciones genéticas a gran escala, con datos de 1 458 biosamples que cubren 369 tipos celulares y tejidos.
El trabajo construye un marco de evaluación para comparar modelos: reunió 10 356 pares elemento–gen medidos con experimentos de perturbación con CRISPR, más de 30 000 eQTLs mapeados con precisión y 569 variantes de GWAS vinculadas a un gen probablemente causal. Con ese “benchmark”, desarrollaron ENCODE-rE2G, un modelo supervisado que entrena sobre datos CRISPR y asigna a cada par elemento–gen una probabilidad de efecto regulador.
Con ENCODE-rE2G, el equipo generó una “enciclopedia” de 92 176 227 interacciones reguladoras entre elementos distales y genes diana. En promedio, por biosample identificó 40 210 elementos reguladores únicos y 63 221 interacciones elemento–gen, y anota 0,89 % de los ~3 000 millones de pares de bases del genoma humano por biosample. Al interpretar el modelo, además de actividad del enhancer y contacto 3D enhancer–promotor, encontraron que también aportan información la “clase” de promotor y la sinergia entre enhancers.
✅ Este atlas permite buscar un gen y ver qué enhancers se le asignan, o tomar una variante no codificante y obtener genes y tipos celulares predichos. También reportan límites: los modelos (incluido ENCODE-rE2G) rinden peor en interacciones más lejanas, con efectos CRISPR pequeños, en elementos sin señal H3K27ac o en genes expresados de forma ubicua; incluso mencionan que fallaron en predecir tres enhancers distales de MYC a casi 2 Mb del TSS.