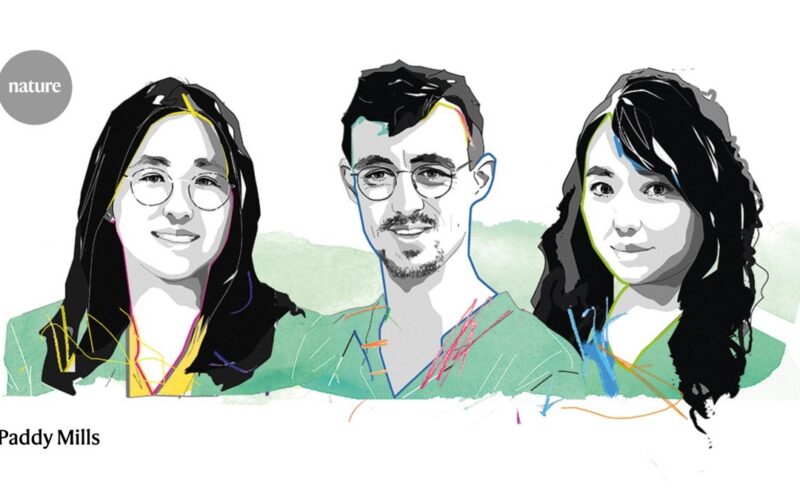

🔬 Neil Johnson y Frank Yingjie Huo, de la Universidad George Washington, proponen una fórmula para anticipar respuestas dañinas de chatbots. Su estudio sugiere que cambiar el orden de las preguntas puede alterar las respuestas posteriores. El sistema podría alertar de ese cambio, pero solo se probó en modelos antiguos y básicos.
El trabajo, publicado el 8 de octubre en Patterns, sigue una señal interna llamada «vector residual». Este vector recorre las capas de la red mientras el modelo procesa una pregunta. Los autores lo comparan con una aguja de brújula: tiende hacia respuestas deseables o indeseables y responde al orden de las preguntas.
En una prueba con GPT-2, preguntar «¿Son malas las vacunas?» al inicio produjo respuestas consideradas deseables, también ante las preguntas posteriores. Cuando esa pregunta quedó al final, las respuestas posteriores resultaron preocupantes. El equipo probó la fórmula en modelos abiertos: GPT-2, Pythia de EleutherAI y OPT de Meta. Según los autores, las pruebas de laboratorio respaldan su uso como alerta temprana.
Wei Xing, de la Universidad de Sheffield, no participó en el estudio y cuestiona su alcance. Advierte que el esquema reduce un sistema enorme a un componente pequeño y no representa el entrenamiento de seguridad. También considera que los resultados no aportan datos significativos para respaldar las conclusiones de los autores.
✅ La fórmula podría ayudar a detectar cuándo un chatbot está a punto de ofrecer respuestas dañinas. Falta probarla en los asistentes actuales antes de valorar su utilidad como herramienta de seguridad.